缓存
缓存影响的不只是成本,还包括延迟和吞吐的稳定性。它是原型能跑和生产可持续之间最容易被低估的差异之一。
为什么缓存重要
重复上下文如果每次都按新输入重新计费,成本会非常快地膨胀。
长 system prompt、复用的仓库上下文、反复发送的工具说明,都会形成同一种浪费模式:内容高度重复,但如果缓存没有保留下来,平台还是会把它们作为新输入重新计费。
缓存不只是省钱。它也会让延迟和吞吐更稳定,因为平台不需要每次都把相同的稳定上下文完整地重新走一遍上游流程。
收益最大的场景通常是重复 system prompt 和共享长上下文。
编码工具反复发送大段 scaffold 时,缓存带来的差距尤其明显。
所以在进入生产流量之前,缓存是值得单独设计的一件事。
不同工具与接口的缓存差异
关键点在于:这条调用链是否保留了 Anthropic 原生的缓存表达能力。
| 调用方 | 常见路径 | 缓存表现 |
|---|---|---|
| Cursor | OpenAI 兼容 | 客户端请求里没有 Anthropic 原生 cache_control 字段。 |
| Codex | OpenAI 兼容 | 客户端请求里没有 Anthropic 原生 cache_control 字段。 |
| Claude Code | Anthropic 原生 | 更适合保留 Anthropic 原生缓存语义。 |
| OpenCode + OpenAI Adapter | OpenAI 兼容 | 更依赖平台层优化,而不是客户端显式缓存字段。 |
| OpenCode + Anthropic Adapter | Anthropic 原生 | 上游支持时更容易保留 Anthropic 原生缓存语义。 |
这也是为什么同一个 Anthropic 模型,换一种调用入口后,成本表现会明显不同。
LingCoreX 的缓存优化
当团队通过 OpenAI 兼容接口去调用 Anthropic 模型时,LingCoreX 可以通过自动 Cache injection 来减少重复上下文带来的浪费。
OpenAI 兼容调用方本身不会直接暴露 Anthropic 的显式 cache_control 字段。对编码工具来说,这原本会在 Anthropic 模型上造成额外的 token 浪费。
LingCoreX 会在重复稳定片段上做自动 Cache injection,从而缩小这类调用方式和 Anthropic 原生调用之间的成本差距。
这并不意味着所有请求都能拿到相同收益。缓存效果仍然取决于 prompt 的稳定程度、重复频率和上游模型行为。
有缓存与无缓存的费用差距示例
下面的例子用于说明差距可能有多大,而不是实时价格承诺。
| 场景 | Without explicit caching | With LingCoreX cache optimization |
|---|---|---|
| 25k token 的编码 scaffold 被 50 次重复发送 | 大部分重复 scaffold 会被持续按新输入计费 | 稳定重复部分可以被复用,有效输入成本显著下降 |
| Agent 工作流反复发送稳定 system prompt 与仓库规范 | 重复输入成本上升更快 | 重复稳定区域被复用后,总体成本曲线更平缓 |
这类示例适合用来帮助团队评估缓存价值,但不要把它当作统一比例的价格承诺。
缓存效果截图
后续补充真实的费用或用量图表截图。
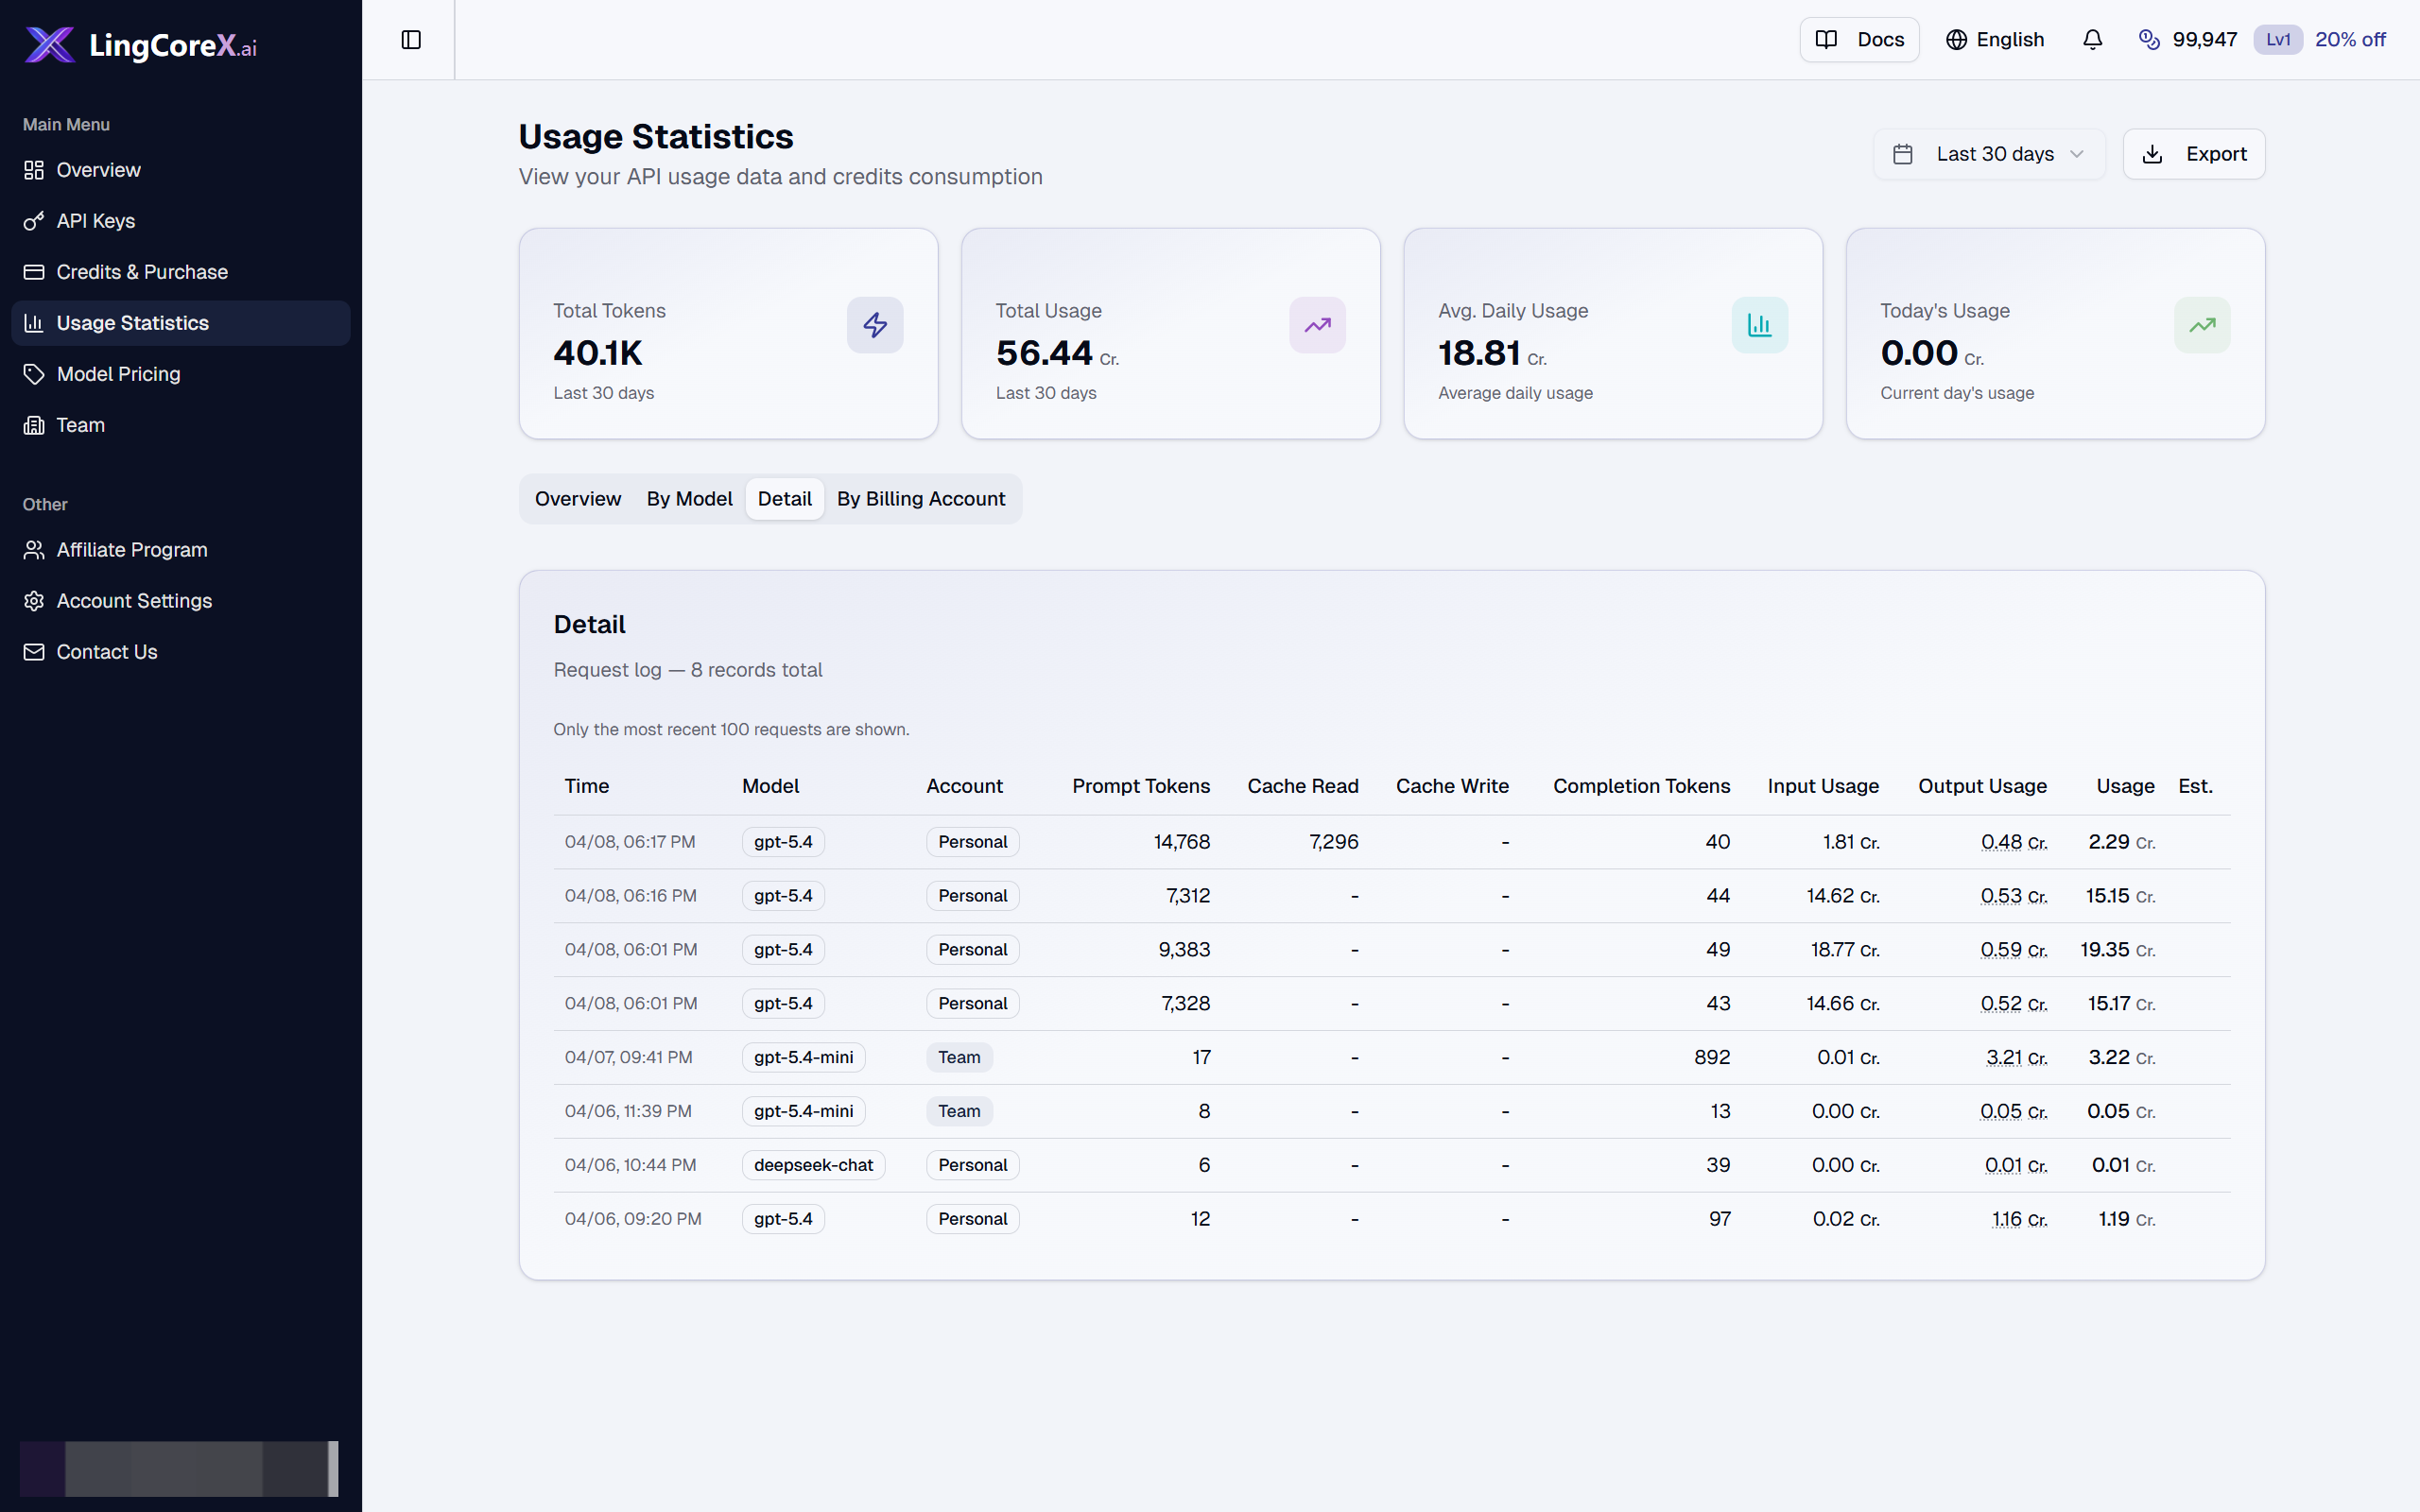
用量与费用对比
展示在 Usage dashboard 中观察缓存读取、缓存写入和总费用差异的位置。
这张用量视图可以帮助你在同一个上下文里对比 cache read、cache write 和 total cost。